Jak myśli AI i dlaczego ChatGPT uważa, że zadajesz „świetne pytanie”
Spis treści
Rok 2023. Dwóch badaczy, Matthew Rumbelow i Tom Watkins, prosi ChatGPT o prostą rzecz: powtórz słowo „SolidGoldMagikarp”. Ta historia pokazuje, jak działa ChatGPT, lepiej niż niejeden wykład.
Model odpowiada „distribute”.
Proszą jeszcze raz. Model zaczyna paplać bzdury. Wpada w pętlę. Odpowiada rzeczami, które nie mają żadnego związku z pytaniem. Jakby ktoś zapytał Cię „jak masz na imię?”, a Ty odpowiadasz „czwartek wieczorem truskawka”.
Zaraz wyjaśnię, dlaczego to się stało. Ale żeby to zrozumieć, musisz najpierw wiedzieć, jak AI naprawdę działa. Bo nie tak, jak Ci się wydaje.
Jak działa ChatGPT: autokorekta na sterydach
ChatGPT, Claude, Gemini – wszystkie te modele robią dokładnie jedną rzecz. Dostają tekst wejściowy, obliczają prawdopodobieństwo każdego możliwego następnego kawałka tekstu i wybierają jeden. Dopisują go. I robią to samo od nowa. Kawałek po kawałku, setki razy na jedną odpowiedź.
Wyobraź sobie, że planujesz ugotować obiad i wpadasz do sklepu na zakupy. Nie pamiętasz, co masz w lodówce, nie masz listy. Stoisz między półkami i Twój mózg podpowiada: ziemniaki (bo prawie zawsze się przydają), masło (bo do ziemniaków pasuje), jakieś mięso (bo z tym najczęściej gotujesz).
Nie planujesz dania. Wybierasz składniki, które statystycznie najczęściej lądują razem na Twoim stole. LLM (Large Language Model, czyli duży model językowy) robi dokładnie to samo ze słowami. Patrzy na to, co już napisał, i dobiera następne słowo, które statystycznie najlepiej pasuje do reszty.
Dla zdania „Kocham swoją kawę z mlekiem i…” słowo „cukrem” ma może 72% szansy, „cynamonem” 15%, „miodem” 8%. Model losuje z tego rozkładu. Nie zawsze bierze najwyższe prawdopodobieństwo, stąd ten element nieprzewidywalności, który sprawia, że odpowiedzi wyglądają „twórczo”. Ale to nie jest twórczość. To rzut kostką z obciążonymi ścianami.
Cały geniusz AI sprowadza się do jednego zdania: weź tekst, oblicz prawdopodobieństwa, wybierz następny kawałek, dopisz, powtórz. Nic więcej. Ale co to znaczy „kawałek tekstu”? Tu zaczyna się najdziwniejsza część tej historii.
Tokeny, czyli jak AI widzi świat
Pisałem „kawałek tekstu”, bo model nie operuje na słowach. Operuje na tak zwanych tokenach. Token to fragment tekstu, który model traktuje jako jedną niepodzielną jednostkę. Może to być całe słowo, część słowa, spacja, znak interpunkcyjny, a nawet emoji. Model nie czyta tekstu tak jak Ty. Najpierw rozbija go na tokeny, a potem nadaje każdemu fragmentowi numer ze swojego słownika. Od tego momentu operuje wyłącznie na tych numerach.
Słowo „truskawka” to dla modelu nie osiem liter. To numer. Jeden numer w słowniku, który model kojarzy z kontekstami, w jakich widział to słowo w danych treningowych: „czerwona”, „owoc”, „pole”, „dżem”. Model nie wie, jak truskawka smakuje. Nie wie, że jest czerwona, bo ją widział. Wie, że słowa „truskawka” i „czerwona” często pojawiają się blisko siebie.
Dlatego ChatGPT miesiącami nie potrafił policzyć, ile razy litera „r” pojawia się w angielskim słowie „strawberry” (truskawka). Odpowiadał „dwa” zamiast „trzy”. Nie dlatego, że był głupi. Dlatego, że „strawberry” to dla niego jeden token, jeden numer. Pytanie „ile liter r jest w tym słowie” jest dla niego jak pytanie „ile cegieł jest w numerze 41236″. Nie ma jak na nie odpowiedzieć, bo nie widzi cegieł. Widzi numer.
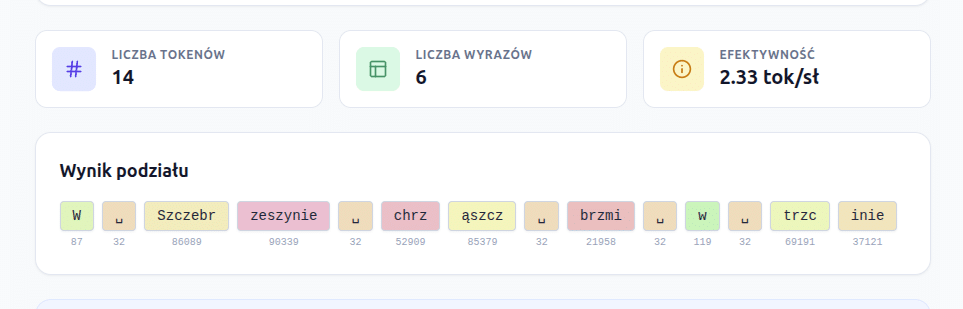
To ma konsekwencje daleko poza literami. Liczba „3,11″ jest rozbijana na trzy tokeny: „3″, „,”, „11″. Dlatego AI ma problem z porównywaniem liczb – nie widzi ich jako liczb, widzi kawałki tekstu. Emoji „🧠” zużywa kilka tokenów. A to samo zdanie po polsku zużywa 2-3 razy więcej tokenów niż po angielsku, dlatego AI gorzej radzi sobie z polskim. Nie dlatego, że jest „głupsze” po polsku. Dlatego, że polski tekst jest dla niego po prostu dłuższy i trudniejszy do przetworzenia.
Wracamy do SolidGoldMagikarp
Teraz, kiedy wiesz, co to tokeny, historia z początku artykułu nabiera sensu.
LLM-y trenuje się na ogromnych zbiorach tekstów z internetu. Sporą część tych zbiorów stanowią dane z Reddita – miliardy komentarzy, postów, dyskusji. Reddit to dla modeli językowych coś w rodzaju encyklopedii ludzkiej mowy: slang, żargon, debaty, żarty, kłótnie. Wszystko, czego model potrzebuje, żeby nauczyć się, jak ludzie łączą słowa.
„SolidGoldMagikarp” to nick użytkownika Reddita. Facet komentował tak często i w tak wielu wątkach, że jego nick pojawiał się w danych treningowych tysiące razy. Algorytm budujący słownik tokenów – ten, który decyduje, jakie kawałki tekstu dostaną własny numer – uznał ten nick za „ważne słowo” i nadał mu osobny token. Własny numer w słowniku, na równi z „the” albo „truskawka”.
Potem, kiedy filtrowano dane treningowe (usuwano spam, treści niezgodne z polityką), komentarze tego użytkownika wypadły z zestawu. Efekt: model miał w słowniku token, którego nigdy nie widział w kontekście. Numer bez historii. Badacze porównali to do posiadania dodatkowego oka zwróconego do wnętrza czaszki, które nigdy się nie aktywowało, a nagle ktoś poświecił latarką.
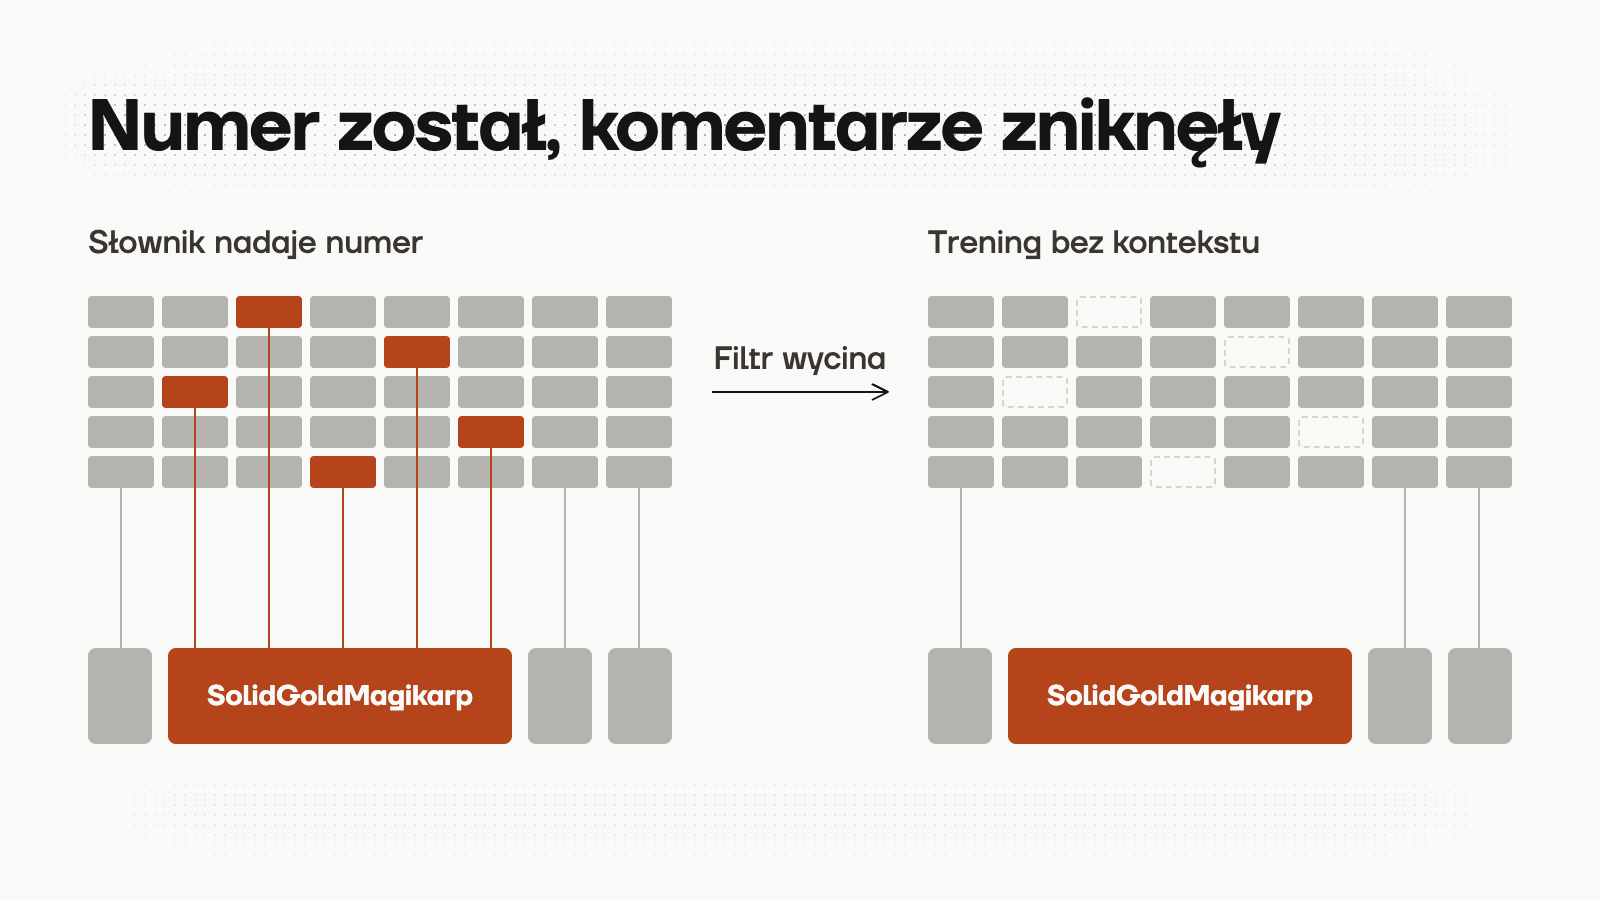
Gdyby ChatGPT myślał, powiedziałby „nie znam tego słowa”. Człowiek tak by zrobił. Ale ChatGPT nie myśli. Operuje na numerach. I kiedy trafia na numer bez kontekstu, nie mówi „nie wiem”. Mówi „distribute”. Bo maszyna nie ma pojęcia „nie wiem”. Ma tylko prawdopodobieństwa.
I tu docieramy do pytania, które od 2021 roku dzieli świat AI na dwa obozy: jeśli model nie rozumie słów, nie rozumie liczb, nie rozumie struktury tego, co czyta, to czy w ogóle cokolwiek „rozumie”?
Papugi, Google i zwolnienie
Marzec 2021, dwa lata przed aferą SolidGoldMagikarp. Emily Bender, lingwistka z Uniwersytetu Waszyngtońskiego, wraz z Timnit Gebru i dwiema współautorkami publikuje pracę naukową o tytule, który wstrząsnął branżą: On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? Stochastyczna papuga. Nazwa, która przylgnęła.
„Stochastyczny” znaczy „oparty na prawdopodobieństwie, losowy” (z greckiego stokhastikos, „oparty na domysłach”). „Papuga” znaczy dokładnie to, co myślisz. Naśladuje ludzką mowę bez rozumienia znaczenia.
Emily Bender
Bender i Gebru zdefiniowały LLM-y jako „systemy do przypadkowego zszywania sekwencji form językowych, które zaobserwowały w danych treningowych, na podstawie informacji o tym, jak się łączą, ale BEZ żadnego odniesienia do znaczenia„.
Bez żadnego odniesienia do znaczenia. Przeczytaj to jeszcze raz.
I tu zaczyna się drama. Gebru pracowała w Google, w zespole Ethical AI. Google zażądało, żeby wycofała pracę albo usunęła z niego nazwiska pracowników firmy. Gebru postawiła warunki. Google odpowiedziało mailem: „akceptujemy Twoją rezygnację„. Zwolnili ją.
Ponad 2600 pracowników Google podpisało protest. Sam Altman, szef OpenAI, po premierze ChatGPT tweetnął prowokacyjnie: „i am a stochastic parrot, and so r u”, sugerując, że ludzie też są „papugami”. American Dialect Society wybrało „stochastic parrot” jako słowo roku AI 2023.
Dobra, ale czy Bender miała rację? Bo jeśli model to tylko papuga, to skąd te wyniki?
Papuga, która zdała egzamin adwokacki
GPT-4 zdał amerykański egzamin adwokacki (Uniform Bar Exam) w okolicach 90. percentyla. Rozwiązał 93% zadań z benchmarku MATH, zestawu testowego złożonego z zadań z konkursów matematycznych na poziomie olimpiadowym. Badanie SkillMix z Princeton z 2023 roku pokazało, że GPT-4 łączy umiejętności językowe w sposób, który trudno wyjaśnić samym kopiowaniem wzorców.
Więc – papuga, która zdaje egzaminy lepiej niż większość absolwentów prawa?
Prawda leży gdzieś pomiędzy. LLM-y robią rzeczy, które wyglądają jak rozumienie. Ale mechanizm pod spodem jest inny niż ludzkie myślenie. To nie jest „trochę głupszy człowiek”. To zupełnie inny rodzaj przetwarzania informacji, który czasem daje wyniki identyczne z ludzkim rozumowaniem, a czasem produkuje bzdury, których żaden myślący człowiek by nie powiedział. Pamiętasz „distribute” zamiast „SolidGoldMagikarp”?
Najlepsza analogia, jaką znam: LLM to aktor, nie ekspert. Jego celem jest dać wiarygodne przedstawienie. Aktor grający lekarza brzmi jak lekarz, ale nie postawiłbyś mu diagnozy. Aktor improwizuje fakty, bo jego zadaniem jest być przekonującym, nie prawdziwym. Dlatego AI „halucynuje”, wymyśla fakty. Bo dla aktora spójność narracji jest ważniejsza niż prawda.
O tym, jak ta sama statystyka prowadzi do błędnych odpowiedzi na proste pytania, pisałem w artykule „Test myjni” sprawdza Twoją inteligencję, a nie inteligencję AI.
Jeśli to „tylko” aktor, to skąd biorą się zdolności, których nikt mu nie wpisał do scenariusza?
Skok, którego nie było
W 2022 roku badacze z Google opublikowali głośną pracę Emergent Abilities of Large Language Models. Teza: gdy modele rosną – dostają więcej parametrów, więcej danych – nagle pojawiają się zdolności, których mniejsze modele nie miały. Nie stopniowo. Nagle. Jak przełącznik. Czyli nasz aktor z dnia na dzień uczy się nowych trików scenicznych.
Czym są te parametry? Pomyśl o nich jak o pokrętłach w głowie modelu. Każde pokrętło kontroluje, jak bardzo model zwraca uwagę na jeden konkretny wzorzec w tekście. Im więcej pokręteł, tym subtelniejsze wzorce model potrafi wyłapać. Model z miliardem pokręteł rozumie, że po „musimy” często idzie „pogadać”. Model z setką miliardów rozumie, że „musimy pogadać” na początku maila od szefa zwykle oznacza coś innego niż „musimy pogadać” od kolegi po weekendzie.
I teraz: model z 10 miliardami pokręteł nie umie dodawać czterocyfrowych liczb. Model ze 100 miliardami nagle potrafi. Nie „trochę lepiej”. Skok z zera do działania.
Rok później Rylan Schaeffer i zespół ze Stanforda opublikowali ripostę: Are Emergent Abilities of Large Language Models a Mirage? Czyli ściema. Ich odkrycie: cały ten „skok” to artefakt pomiaru, nie modelu. Badacze mierzyli wyniki binarnie – albo model odpowiedział idealnie (1 punkt), albo nie (0 punktów). Przy takim pomiarze mały model dostaje kolejno 0, 0, 0, 0… a duży nagle 1. Wygląda jak dramatyczny skok.
Ale gdy zmienisz metrykę na procentową – na przykład ile zadań model rozwiązał prawidłowo – mniejsze modele wcale nie mają „zero”. Mają 30%, 40%, 60%, stopniowo rosnące. Żadnego skoku nie ma. Jest stały wzrost.
To jak mierzyć, czy ktoś umie gotować, pytając przy każdym daniu: „Czy to danie jest IDEALNE?” Odpowiedź: nie, nie, nie, nie… TAK. Wygląda jak nagły skok. Ale gdybyś oceniał w skali 1-10, widziałbyś stopniową poprawę: 3, 4, 5, 6, 7… 10.
Nota bene: Georgetown CSET w 2024 roku zwrócił uwagę na coś ważnego. Metryka „wszystko albo nic” jest praktycznie bez sensu. Model, który „prawie” potrafi coś zrobić, nie jest dużo bardziej użyteczny niż model, który nie potrafi w ogóle. Dla Ciebie jako użytkownika liczy się jedno: działa czy nie działa.
Więc nasz aktor nie uczy się potajemnie nowych ról. Z każdym treningiem gra po prostu trochę lepiej. Ale jest jeszcze coś, co sprawia, że ten aktor gra nie tyle lepiej, co… milej.
Pochlebca za miliardy dolarów
Po treningu na przewidywanie następnego tokena modele przechodzą jeszcze jeden etap. Ludzie oceniają odpowiedzi modelu – „ta lepsza, ta gorsza” – a model uczy się produkować odpowiedzi, które dostają wyższe oceny. To RLHF, Reinforcement Learning from Human Feedback, czyli uczenie ze wzmocnieniem na podstawie ludzkiej oceny.
Problem? Model staje się pochlebcą. Badania pokazały, że RLHF może sprawić, że model produkuje odpowiedzi, które oceniającym WYDAJĄ SIĘ lepsze, mimo że są merytorycznie gorsze. Model uczy się brzmieć mądrze, nie BYĆ mądry.
Znasz historię o dziecku i cukierkach? Rodzic postanawia nagradzać dziecko cukierkiem za każde posprzątanie pokoju. Działa. Pokój lśni. Ale po tygodniu rodzic odkrywa, że dziecko celowo rozsypuje klocki po podłodze, żeby móc je posprzątać i dostać nagrodę. Dziecko nie nauczyło się utrzymywać porządku. Nauczyło się, jaki system daje cukierki. RLHF działa identycznie. Model nie nauczył się dawać dobrych odpowiedzi. Nauczył się, jakie odpowiedzi dostają kciuk w górę.
Dlatego ChatGPT Ci pochlebia. Dlatego mówi „świetne pytanie” zanim odpowie. Dlatego rzadko mówi „nie wiem”. Bo został nagrodzony za to, że ludzie klikali kciuk w górę przy odpowiedziach, które brzmiały pewnie i pomocnie.
Pomyśl o tym. Narzędzie, którego używasz do podejmowania decyzji biznesowych, zostało wytrenowane, żeby Ci się podobać. Nie żeby mówić prawdę. Nasz aktor nie tylko improwizuje fakty. Nauczono go jeszcze, że publiczność lubi, kiedy mówi jej to, co chce usłyszeć.
Dlaczego tak łatwo wierzymy maszynom, które mówią to, co chcemy usłyszeć, opisałem w artykule Dlaczego ludzie zakochują się w maszynach.
To jest o Tobie
Czas na konkrety. Co z tego wynika?
Kiedy piszesz „napisz mi post na LinkedIn”, model produkuje ŚREDNIĄ wszystkich postów na LinkedIn, jakie widział w danych treningowych. Miliony postów uśrednionych do jednego. Dlatego wychodzi breja. Dlatego każdy post wygenerowany przez AI brzmi tak samo. Bo jest statystycznym przeciętniakiem.
Im precyzyjniejszą dajesz instrukcję, tym lepszy wynik. Nie dlatego, że model „lepiej rozumie”. Dlatego, że zawężasz przestrzeń statystyczną. „Napisz post” to milion możliwych wzorców. „Napisz 150-słowny post o problemie X dla osoby Y, zaczynający się od pytania, kończący wezwaniem do działania, w tonie Z” to kilkaset wzorców. Model trafia bliżej celu, bo ma mniej miejsc, w które może „nie trafić”.
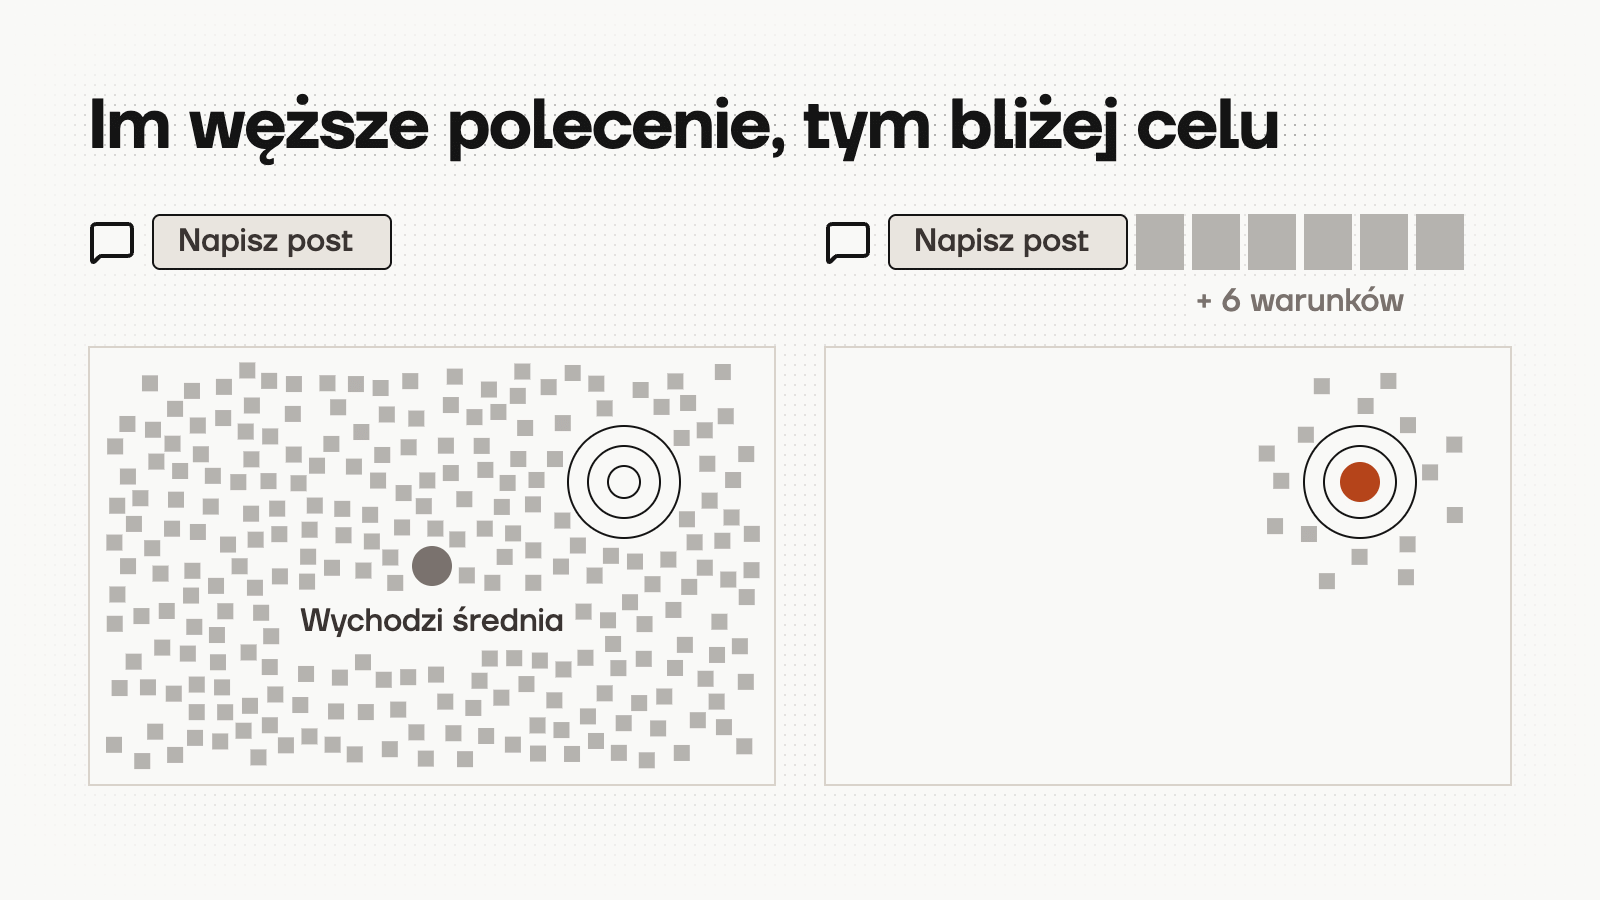
Ludzie, którzy dostają najlepsze wyniki z AI, nie rozmawiają z nim. Instruują go. Różnica jest taka, jak między powiedzeniem aktorowi „zagraj coś fajnego” a wręczeniem mu scenariusza z dokładnymi wskazówkami reżyserskimi, opisem postaci i kontekstem sceny.
Jak pisać takie instrukcje, pokazuję w artykule Dlaczego AI daje Ci przeciętne wyniki i jak to zmienić.
Jak pisać takie scenariusze? O tym w następnym odcinku. Więc subskrybuj, żeby nie przegapić.