Co to jest ElevenLabs Scribe v3? Dokładniejszy zapis mowy
Spis treści
- Co dokładnie ogłosiło ElevenLabs?
- Co nowe modele potrafią w codziennej pracy?
- Kto co powiedział na spotkaniu
- Skąd agent głosowy wie, że rozmówca skończył mówić
- Słownik firmy, języki i format zapisu
- Jak ElevenLabs zmierzyło dokładność i co znaczą te procenty?
- Co pokazał test w holenderskiej firmie energetycznej?
- Gdzie to działa, za ile i czego jeszcze nie wiadomo?
- Najczęstsze pytania
- Czy Scribe v3, model ElevenLabs zamieniający mowę na tekst, rozpoznaje, kto mówi, w trakcie rozmowy?
- Ile błędów mniej robi Scribe v3 niż Scribe v2?
- Co różni Scribe v3 od Scribe v3 Live?
- Jak przesiąść się ze Scribe v2 na Scribe v3?
Co to jest ElevenLabs Scribe v3? To nowy model zamiany mowy na tekst. ElevenLabs ogłosiło go w dwóch wersjach: Scribe v3 do nagrań i Scribe v3 Live do rozmów na żywo. Według ElevenLabs wersja do nagrań myli się w słowach o 27% rzadziej niż Scribe v2. To średnia ze 102 języków. Poza dokładnością jest też nowość: wersja Live po raz pierwszy rozpoznaje, kto mówi, jeszcze w trakcie rozmowy.
Wyobraź sobie zebranie, na którym trzy osoby mówią naraz. Albo klienta, który dzwoni z ruchliwej ulicy i milknie w połowie zdania, bo szuka numeru umowy. Starsze systemy gubią wtedy słowa, przypisują je złej osobie albo przerywają rozmówcy. ElevenLabs twierdzi, że nowe modele powstały z myślą właśnie o takich nagraniach.
Co dokładnie ogłosiło ElevenLabs?
Premiera odbyła się 10 listopada 2026. Jak czytamy w ogłoszeniu ElevenLabs, firma wypuściła dwa modele naraz:
- Scribe v3 służy do nagrań, które już masz na dysku, na przykład nagrania spotkania albo wywiadu.
- Scribe v3 Live działa na żywo, z małym opóźnieniem, i popełnia o 43% mniej błędów niż Scribe v2 Realtime.
Nowością w wersji Live jest rozpoznawanie mówców (w branży mówi się „diaryzacja”). Dochodzi do tego lepsze wyczuwanie momentu, w którym rozmówca skończył mówić.
Skąd te zmiany? ElevenLabs pisze, że zespoły korzystające ze Scribe prosiły w kółko o pięć rzeczy:
- Lepsze rozpoznawanie mówców przy szybkiej wymianie zdań i przy trzech lub więcej osobach.
- Koniec z przerywaniem rozmówcy, który zrobił pauzę albo powoli dyktuje numer.
- Wersja na żywo tak dokładna jak wersja do nagrań.
- Hindi na poziomie angielskiego, także gdy ktoś miesza oba języki w jednym zdaniu.
- Większa kontrola nad wynikiem, od zapisu liczb po długie listy nazw produktów.
Co nowe modele potrafią w codziennej pracy?
Kto co powiedział na spotkaniu
W protokole z zebrania wypowiedź przypisana złej osobie szkodzi protokołowi tak samo jak pomyłka w słowie. Przy nagraniach z trzema lub więcej osobami Scribe v3 rzadziej przypisuje wypowiedź złej osobie niż Scribe v2. Błędów jest o 17% mniej. To właśnie te nagrania, na których według ElevenLabs wykłada się większość istniejących modeli.
Wersja Live myli mówców o 39% rzadziej niż najlepszy z pozostałych modeli na żywo, które firma testowała. Dla Ciebie to zapis spotkania z klientem, w którym wiadomo, kto zgłosił poprawki.
Skąd agent głosowy wie, że rozmówca skończył mówić
Agent głosowy, czyli program, który rozmawia z klientem przez telefon, musi zgadnąć, kiedy człowiek skończył mówić. Tradycyjne systemy liczą sekundy ciszy. Gdy agent czeka na ciszę krótko, przerywa ludziom w pół zdania. Gdy czeka długo, wydaje się ospały.
Scribe v3 Live bierze pod uwagę dźwięk i sens rozmowy. Klient, który dyktuje numer zamówienia i zatrzymuje się w połowie, dokończy go spokojnie. ElevenLabs pisze, że to ten sam mechanizm, którego używa już ElevenAgents, czyli narzędzie firmy do budowania agentów głosowych. Ten mechanizm jest teraz także w ElevenAPI, czyli interfejsie dla programistów, przez który podłączasz modele do własnej aplikacji.
Słownik firmy, języki i format zapisu
Scribe v3 przyjmuje słownik do tysiąca terminów, które na pewno padną w nagraniu: nazwy marek, skróty, żargon branżowy. Możesz też wybrać, czy liczby pojawią się jako cyfry, czy słownie. Reguły formatu wpisujesz zwykłym zdaniem po angielsku, na przykład że każda data ma mieć układ rok-miesiąc-dzień.
W wersji Live dochodzi tryb wielojęzyczny do rozmów, w których ktoś zmienia język w pół zdania. Ma też bibliotekę terminów, która mieści tysiące haseł, za dużo na zwykły słownik. Model zagląda do niej dopiero wtedy, gdy usłyszy słowo podobne do któregoś hasła.
Jak ElevenLabs zmierzyło dokładność i co znaczą te procenty?
Firma porównała oba modele z poprzednimi wersjami i z innymi popularnymi modelami na tych samych zbiorach nagrań. Dokładność w wielu językach sprawdziła na własnej wersji testu FLEURS, czyli zestawu krótkich, czystych nagrań czytanego tekstu. W tym teście w każdym nagraniu mówi jedna osoba, więc nie sprawdzisz na nim, czy model dobrze rozpoznaje mówców. Dlatego ElevenLabs zbudowało też własny zbiór prawdziwych spotkań, rozmów z agentami i notatek głosowych w 16 językach. Zapowiada, że wkrótce go udostępni.
Przy wersji Live firma pokazuje przede wszystkim błędy znaczeniowe. Liczy się wtedy tylko pomyłka, która zmienia sens zapisu, a różnice w interpunkcji czy zapisie liczb już nie. W tej mierze Live myli się o 43% rzadziej, o czym była już mowa. W zwykłym liczeniu błędnych słów myli się o 31% rzadziej.
Najciekawsze w ogłoszeniu jest to, że procenty przeliczono na codzienną pracę. Godzinne spotkanie to około dziewięciu tysięcy słów. Jeden model myli 4% słów, drugi 2%. Różnica to 180 błędnych słów, czyli trzy na każdą minutę mówienia.
Przy przypisywaniu wypowiedzi w tym samym godzinnym spotkaniu każdy punkt procentowy błędu oznacza 36 sekund mowy przypisanych złej osobie. Najczęściej błędy trafiają się właśnie w nazwiskach, liczbach i skrótach. W podcaście pomyłka to literówka. W zapisie telekonferencji o wynikach spółki „piętnaście” usłyszane jako „pięćdziesiąt” trafia prosto do arkusza analityka.
Co pokazał test w holenderskiej firmie energetycznej?
Eneco dostarcza energię do ponad dwóch milionów domów i firm w Holandii. Jej agent głosowy działa na ElevenAgents, a firma przetestowała na tym agencie Scribe v3 Live przed premierą. W prawdziwych rozmowach z klientami agent rozpoznawał holenderskie kody pocztowe za pierwszym razem o 40% częściej. Numery domów rozpoznawał za pierwszym razem o 15% częściej. Klient rzadziej musiał więc powtarzać kod.
Ruud Huigsloot z Eneco mówi: „ElevenLabs to dla Eneco prawdziwy partner. Razem z ich inżynierami pracujemy nad dalszym ulepszaniem naszego agenta głosowego”. Sama laurka niewiele mówi. Ważniejsze, że liczby obok niej pochodzą z prawdziwych rozmów z klientami. Od kodu pocztowego zaczyna się weryfikacja dzwoniącego, więc jedna źle usłyszana cyfra potrafi ją wywrócić.
Gdzie to działa, za ile i czego jeszcze nie wiadomo?
Scribe v3 Live działa od dnia premiery w ElevenAgents. Oba modele są domyślne w aplikacji ElevenLabs i dostępne w ElevenAPI. Twoja aplikacja jest podłączona do Scribe v2 przez ElevenAPI? Wtedy przesiadka to zmiana jednej nazwy modelu w ustawieniach. Nowa nazwa to scribe_v3 albo scribe_v3_live.
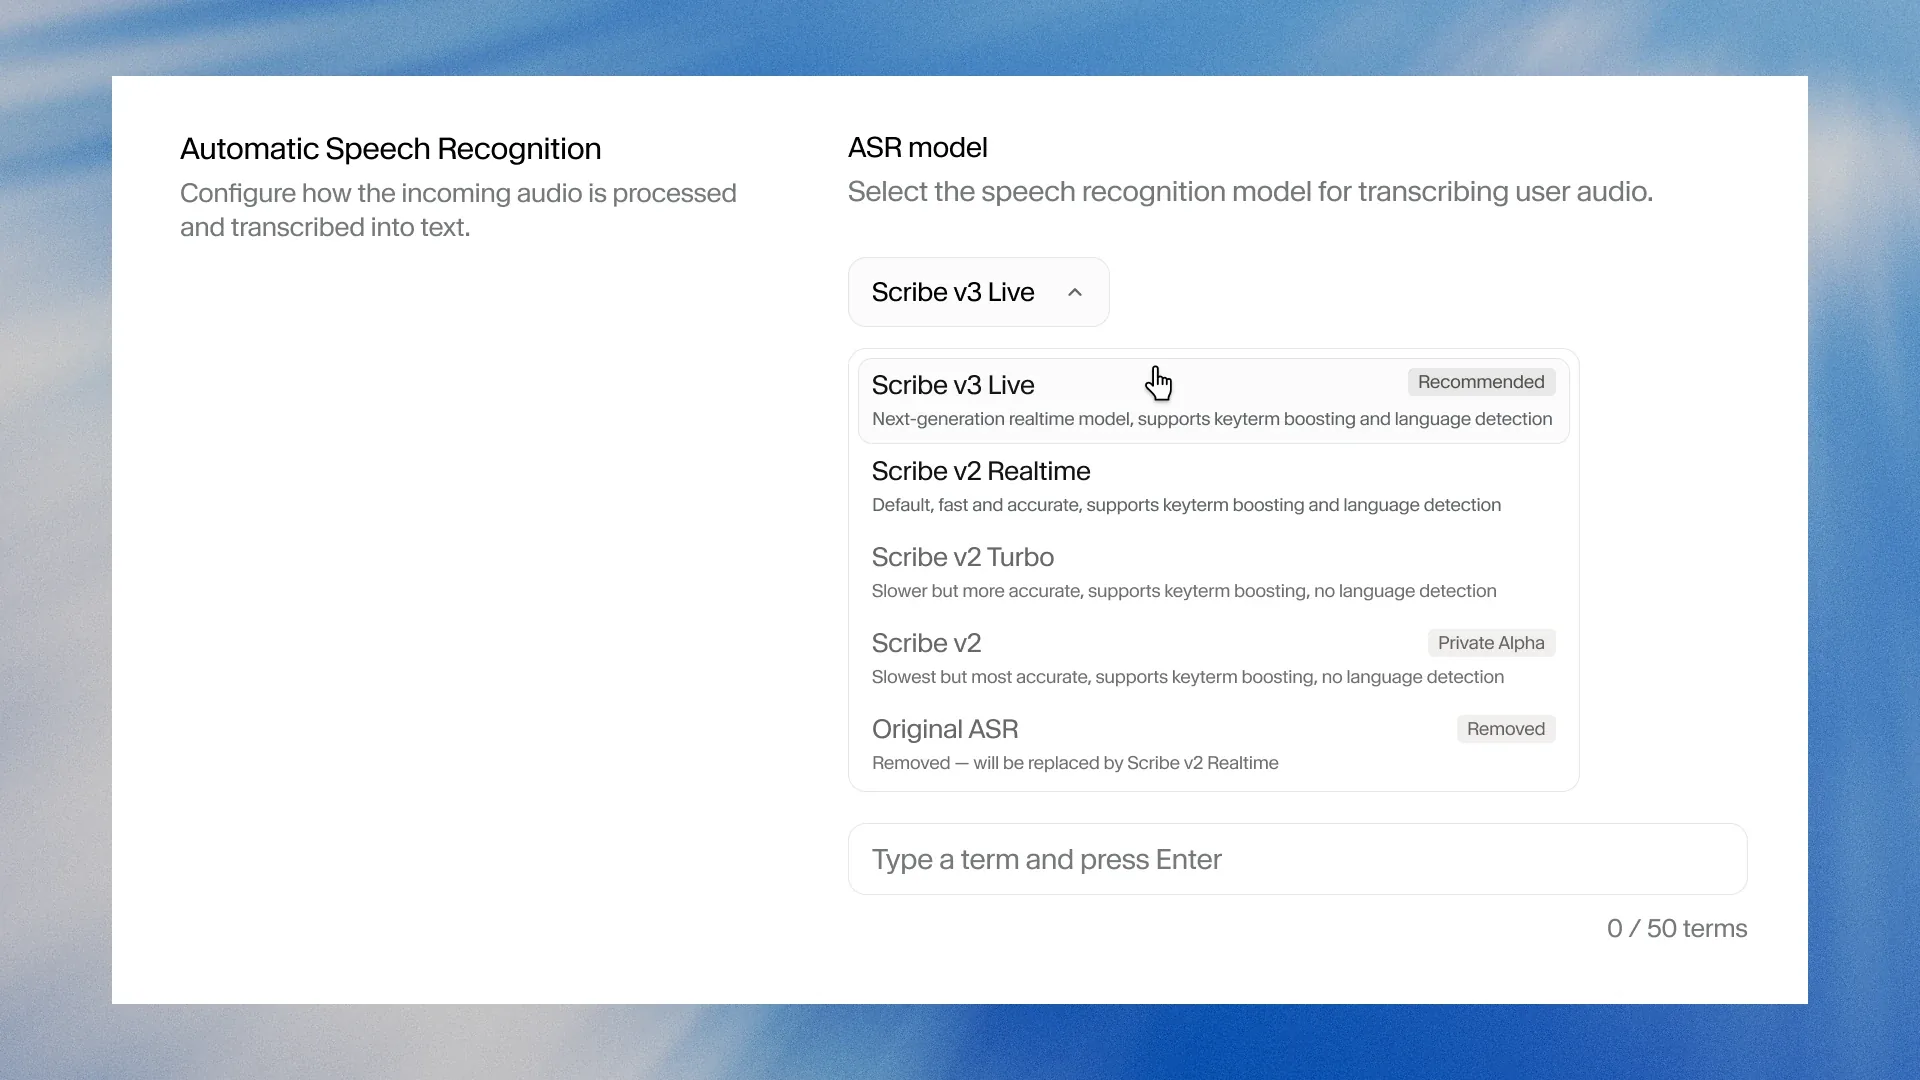
Modele działają domyślnie w USA. Klienci korporacyjni z wymogami co do miejsca przechowywania danych mogą wybrać odizolowane środowiska. To osobne instalacje usługi w UE, Indiach i Singapurze. Tryb bez przechowywania danych (Zero Retention Mode) kasuje dźwięk i tekst zaraz po zakończeniu zapytania. Oba modele są objęte programami zgodności z międzynarodowymi standardami bezpieczeństwa danych: SOC 2 i ISO 27001. Dla danych kart płatniczych obejmuje je także PCI DSS. Zespoły medyczne mogą używać obu modeli zgodnie z HIPAA, czyli amerykańskimi przepisami o ochronie danych pacjentów. Warunkiem jest podpisanie z ElevenLabs osobnej umowy o przetwarzaniu tych danych.
Ogłoszenie zostawia kilka pytań bez odpowiedzi:
- Nie podaje ceny ani informacji, czy nowe modele kosztują więcej niż Scribe v2.
- Nie wymienia osobno wyniku dla polskiego, choć mówi o poprawie we wszystkich testowanych językach.
- Nie mówi, czy środowisko w UE jest dostępne dla mniejszych klientów.
- Nie podaje daty udostępnienia własnego zbioru nagrań.
Co zrobić z tą wiedzą? Jeśli używasz aplikacji ElevenLabs do notatek ze spotkań, nic nie musisz robić, bo nowe modele są tam domyślne. Jeśli masz agenta głosowego albo integrację ze Scribe v2, zmień identyfikator. Potem porównaj wyniki na kilku własnych nagraniach z nazwami produktów i numerami. Sprawdź też cennik na koncie, zanim przepuścisz przez model większą partię nagrań.
Nagrywasz rozmowy z danymi klientów? Zanim cokolwiek wyślesz, zapytaj dział sprzedaży ElevenLabs o środowisko w UE i tryb bez przechowywania danych. Szerzej o tym, czego nie wpisywać do AI, pisałem osobno. A jeśli budujesz z ElevenLabs więcej niż transkrypcję, zajrzyj do opisu modelu efektów SFX v3 i narzędzia Ads Engine.
Najczęstsze pytania
Czy Scribe v3, model ElevenLabs zamieniający mowę na tekst, rozpoznaje, kto mówi, w trakcie rozmowy?
Tak, robi to wersja Scribe v3 Live. To nowość: rozpoznawanie mówców, w branży zwane diaryzacją, działa jeszcze w trakcie rozmowy. Wersja Live myli mówców o 39% rzadziej niż najlepszy z pozostałych modeli na żywo, które firma testowała. Dla Ciebie to spisany tekst spotkania z klientem, w którym wiadomo, kto zgłosił poprawki.
Ile błędów mniej robi Scribe v3 niż Scribe v2?
Według ElevenLabs, firmy, która tworzy Scribe, wersja do nagrań myli się w słowach o 27% rzadziej niż Scribe v2. To średnia ze 102 języków. Scribe v3 Live popełnia o 43% mniej błędów niż Scribe v2 Realtime, czyli starszy model do pracy na żywo. Przy nagraniach z trzema lub więcej osobami błędów w rozpoznawaniu, kto mówi, jest o 17% mniej.
Co różni Scribe v3 od Scribe v3 Live?
Scribe v3 służy do nagrań, które masz już na dysku, na przykład nagrania spotkania albo wywiadu. Scribe v3 Live działa na żywo, z małym opóźnieniem. Nowością w wersji Live jest rozpoznawanie mówców. Dochodzi lepsze wyczuwanie momentu, w którym rozmówca skończył mówić. Wersja Live ma też tryb wielojęzyczny do rozmów, w których ktoś zmienia język w pół zdania.
Jak przesiąść się ze Scribe v2 na Scribe v3?
Wystarczy zmienić jedną nazwę modelu w ustawieniach, jeśli aplikacja jest podłączona do Scribe v2 przez ElevenAPI. Nowa nazwa to scribe_v3 albo scribe_v3_live. ElevenAPI to interfejs dla programistów, przez który podłączasz modele do własnej aplikacji. Potem porównaj wyniki na kilku własnych nagraniach z nazwami produktów i numerami.
Artykuł powstał w oparciu o: https://elevenlabs.io/blog/scribe-v3